这个项目在做什么
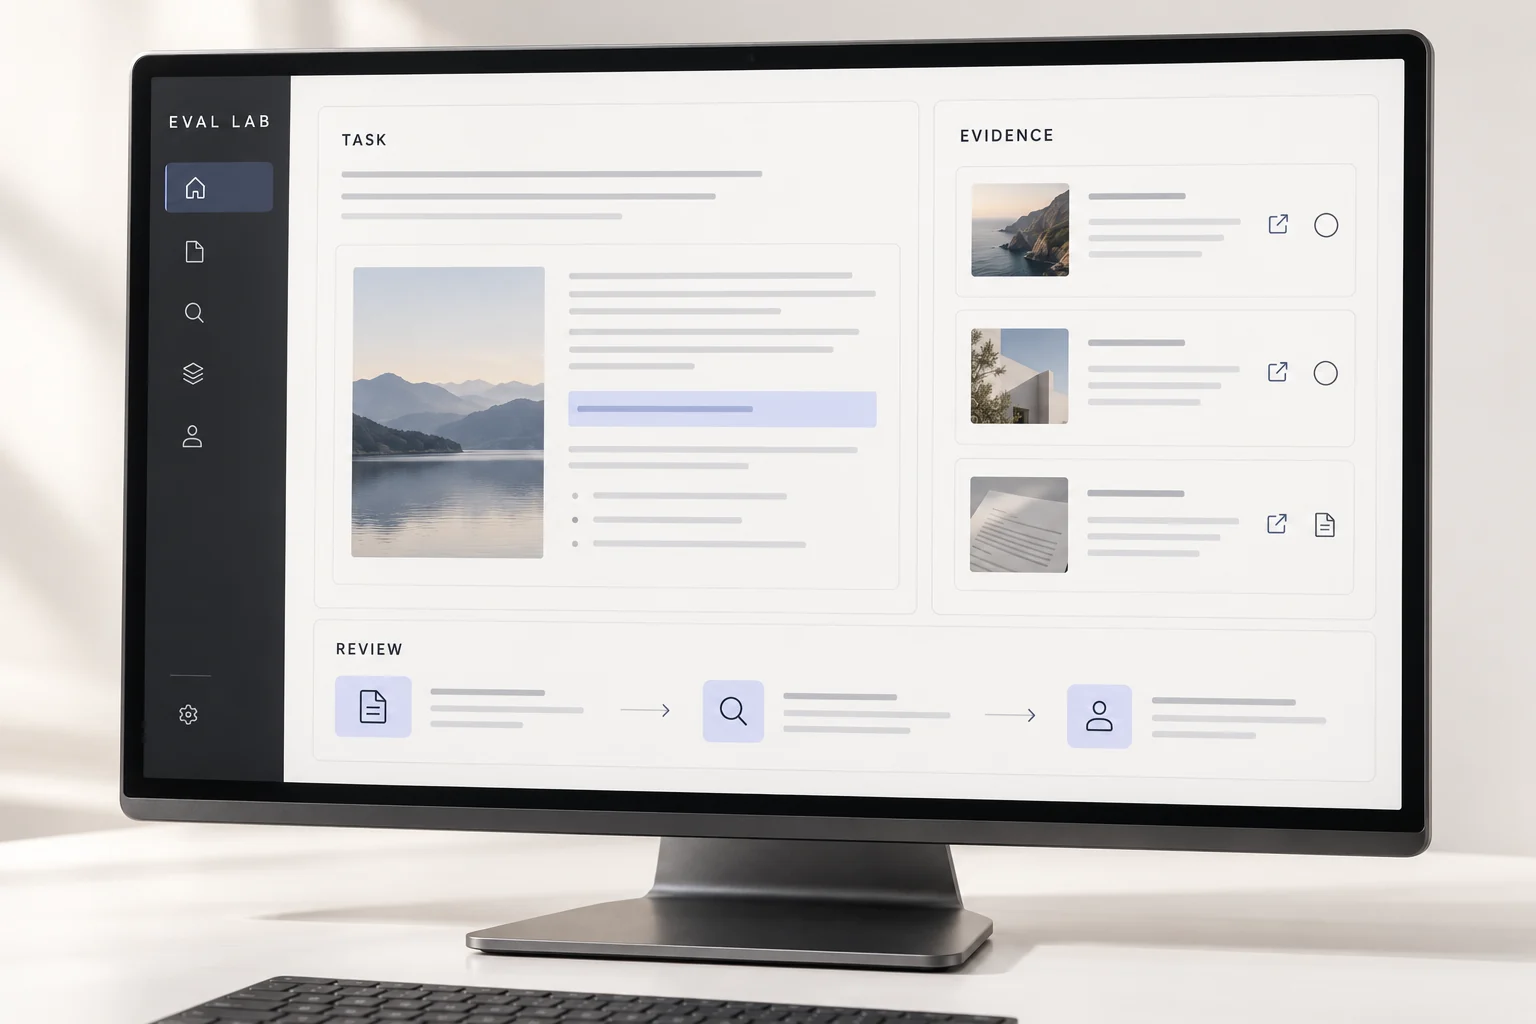
整理办公与工具使用基准、LLM-as-a-Judge 和不确定性研究,把确定性校验、语义判定、人工复核放在同一评测框架内。重点关注逐项证据、规则版本、误判与漏检、风险和自动覆盖率之间的关系。
从产物开始,而不是从一句“完成了”开始
一次 Agent 任务可能经过检索、工具调用、文件生成和交付。评测时,我先检查最终产物与任务要求是否对应,再判断过程中的证据是否充分。文件能打开、字段存在、链接有效等确定性问题,应当先用规则检查。
把评分拆到可以复核的粒度
语义判断需要一份有版本的 Rubric。每项标准都应说明判断对象、通过条件与需要的证据;缺少材料时,保留“无法判断”,而不是强行给分。模型评分与人工复核分开记录,才有机会解释分歧。
用风险与覆盖率决定自动化范围
自动判定覆盖更多案例,不一定意味着整体质量更好。我关心被自动通过的案例中漏掉了什么,也关心哪些不确定案例值得交给人工。随机抽查与边界样本一起看,才能识别只在熟悉样本上表现良好的方案。
主要工作
- 基准与一手论文阅读
- 逐项证据与可复核评分
- 随机审计、边界样本与稳定性检查
公开呈现通用研究方法与方案,不代表已全面替代人工复核。